
Cara Kerja Kompresi ZIP: Algoritma Huffman
Pelajari cara kerja kompresi ZIP lewat algoritma Huffman: pohon biner, kode prefiks, contoh menghitung kata MATEMATIKA, dan kode Python.
- Mapel
- Pemrograman
- Jenjang
- SMA, Kuliah
- Waktu baca
- 10 menit
- Terbit
- 9 November 2026
- Penyusun
- Risyad Raflan
File ZIP bisa jauh lebih kecil daripada file aslinya karena komputer tidak lagi memberi jatah bit yang sama untuk setiap huruf. Huruf yang sering muncul diberi kode biner pendek, huruf yang jarang muncul diberi kode panjang, sehingga total bitnya menyusut tanpa ada informasi yang hilang. Cara memilih kode-kode itu secara optimal dikenal sebagai algoritma Huffman, dan ide sederhananya masih bekerja di balik format kompresi yang kamu pakai hampir setiap hari.
Di artikel ini kita bedah cara kerjanya: dari kisah tugas kuliah yang melahirkannya, langkah membangun pohon Huffman, contoh menghitung kata "MATEMATIKA" sampai tinggal 25 bit, hingga kode Python yang bisa langsung kamu jalankan.
Kenapa Teks Bisa Dikompresi?
Dalam pengodean teks yang paling sederhana, setiap karakter disimpan dengan jumlah bit yang sama, misalnya 8 bit (1 byte) per karakter. Kata "MATEMATIKA" yang terdiri dari 10 huruf berarti butuh bit.
Masalahnya, huruf-huruf itu tidak muncul sama sering. Di kata "MATEMATIKA", huruf A muncul 3 kali, sedangkan E hanya sekali. Memberi A dan E jatah 8 bit yang sama itu boros. Kalau A cukup diberi 2 bit dan E diberi 3 bit, totalnya bisa turun drastis. Inilah prinsip kode panjang-variabel (variable-length code): simbol yang sering muncul mendapat kode lebih pendek.
Kompresi semacam ini disebut lossless (tanpa kehilangan): setelah file dibuka kembali, isinya sama persis, bit demi bit, dengan aslinya. Itu sebabnya ZIP aman untuk dokumen, kode program, atau data apa pun yang tidak boleh berubah satu karakter pun.
Syarat Penting: Kode Prefiks
Kode panjang-variabel punya jebakan. Misalkan A = 0, B = 01, dan C = 1. Saat komputer membaca deretan 01, apakah itu "AC" atau "B"? Ambigu.
Huffman menghindari masalah ini dengan membuat kode prefiks (prefix code), yaitu kode yang tidak ada satu pun menjadi awalan (prefiks) dari kode lain. Dengan kode prefiks, komputer bisa membaca bit dari kiri ke kanan dan langsung tahu kapan satu huruf selesai, tanpa perlu tanda pemisah.
Cara paling mudah memastikan sifat prefiks adalah menaruh semua huruf di daun sebuah pohon biner. Setiap cabang kiri diberi bit 0, setiap cabang kanan diberi bit 1, dan kode sebuah huruf adalah urutan bit dari akar sampai ke daunnya. Karena huruf hanya ada di ujung daun, jalur menuju satu huruf tidak mungkin menjadi awal jalur huruf lain.
Kisah di Balik Algoritma Huffman
Pada 1951, David A. Huffman adalah mahasiswa doktoral (Sc.D.) di MIT yang mengikuti kuliah teori informasi. Dosennya, Robert M. Fano, memberi pilihan kepada mahasiswa: mengerjakan makalah (term paper) atau ujian akhir. Topik makalahnya adalah mencari kode biner yang paling efisien.
Huffman sempat buntu karena tidak bisa membuktikan kode mana yang paling efisien, dan hampir menyerah untuk belajar ujian. Lalu ia menemukan ide membangun pohon biner berdasarkan frekuensi dari bawah ke atas, dan berhasil membuktikan bahwa cara ini optimal. Pendekatan ini mengungguli metode Shannon–Fano yang dikembangkan Fano bersama Claude Shannon, yang membangun pohon dari atas ke bawah dan tidak selalu optimal.
Hasilnya terbit sebagai makalah "A Method for the Construction of Minimum-Redundancy Codes" di jurnal Proceedings of the IRE edisi September 1952. Huffman kemudian mengajar di MIT mulai 1953, lalu pada 1967 menjadi dosen pendiri Departemen Ilmu Komputer di UC Santa Cruz. Ia wafat pada 7 Oktober 1999 dalam usia 74 tahun, tahun yang sama ketika ia menerima IEEE Richard W. Hamming Medal.
Langkah Membangun Pohon Huffman
Algoritmanya pendek dan bisa dikerjakan dengan pensil:
- Hitung frekuensi setiap simbol, lalu jadikan masing-masing sebagai simpul daun.
- Ambil dua simpul dengan frekuensi terkecil.
- Gabungkan keduanya menjadi simpul baru yang frekuensinya adalah jumlah keduanya. Simpul pertama menjadi anak kiri (bit
0), simpul kedua menjadi anak kanan (bit1). - Masukkan simpul baru itu kembali ke daftar.
- Ulangi langkah 2–4 sampai hanya tersisa satu simpul. Simpul itu adalah akar pohon.
Kuncinya ada di langkah 2: simbol yang paling jarang selalu digabung lebih dulu, sehingga mereka berada paling dalam di pohon dan mendapat kode paling panjang. Simbol yang sering muncul baru masuk belakangan dan berakhir dekat akar dengan kode pendek.
Untuk mengambil dua simpul terkecil dengan cepat, program biasanya memakai antrean prioritas (priority queue). Dengan struktur data ini, membangun pohon untuk simbol membutuhkan waktu .
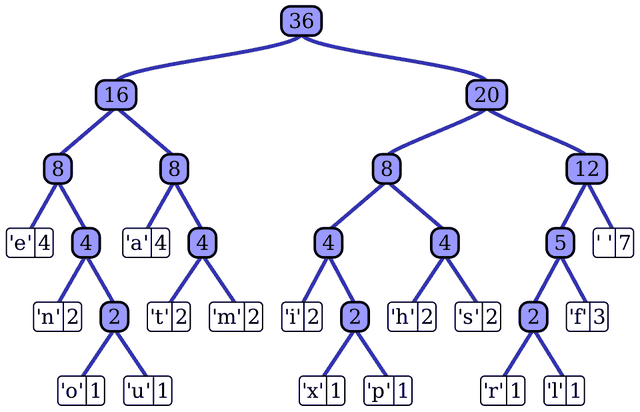
Gambar berikut adalah pohon Huffman untuk kalimat bahasa Inggris "this is an example of a huffman tree" (36 karakter). Perhatikan angka di setiap simpul ungu: itu jumlah frekuensi kedua anaknya, dan akarnya bernilai 36. Spasi yang muncul 7 kali berada dekat akar, sedangkan huruf yang hanya muncul sekali seperti x, p, r, dan l berada paling bawah.
Gambar: pohon Huffman untuk kalimat "this is an example of a huffman tree" oleh Meteficha, via Wikimedia Commons, domain publik (dilepas oleh pembuatnya). (diubah: dirender ke PNG, diperkecil, latar dibuat putih)
Dengan pohon ini, seluruh kalimat bisa dikodekan dalam 135 bit, dibandingkan 288 bit bila setiap karakter memakai 8 bit (dengan asumsi penerima sudah tahu bentuk pohonnya).
Contoh Menghitung: Mengompresi Kata "MATEMATIKA"
Sekarang kita kerjakan sendiri langkah demi langkah.
Langkah 1 — Hitung frekuensi.
| Huruf | A | M | T | E | I | K |
|---|---|---|---|---|---|---|
| Frekuensi | 3 | 2 | 2 | 1 | 1 | 1 |
Totalnya huruf.
Langkah 2 — Gabungkan dua terkecil berulang kali.
- E (1) + I (1) → simpul EI bernilai 2.
- K (1) + M (2) → simpul KM bernilai 3.
- T (2) + EI (2) → simpul bernilai 4.
- A (3) + KM (3) → simpul bernilai 6.
- Simpul 4 + simpul 6 → akar bernilai 10.
Akar bernilai 10 sama dengan jumlah huruf, tanda tidak ada yang tercecer.
Langkah 3 — Baca kode dari akar ke daun (kiri = 0, kanan = 1).
| Huruf | Frekuensi | Kode | Panjang | Frekuensi × panjang |
|---|---|---|---|---|
| A | 3 | 10 |
2 | 6 |
| T | 2 | 00 |
2 | 4 |
| M | 2 | 111 |
3 | 6 |
| E | 1 | 010 |
3 | 3 |
| I | 1 | 011 |
3 | 3 |
| K | 1 | 110 |
3 | 3 |
| Jumlah | 10 | 25 |
Jadi "MATEMATIKA" cukup ditulis dengan 25 bit:
Rasio ukurannya:
Artinya, data utama menyusut sekitar 69%. Bahkan dibandingkan kode panjang-tetap 3 bit per huruf (cukup untuk 6 huruf berbeda, total bit), Huffman masih lebih hemat 5 bit.
Cek: urai kembali bitnya dari kiri. 111 hanya cocok dengan M, lalu 10 = A, 00 = T, 010 = E, 111 = M, 10 = A, 00 = T, 011 = I, 110 = K, 10 = A. Hasilnya kembali "MATEMATIKA", dan bit.
Seberapa Dekat dengan Batas Teoretis?
Claude Shannon pada 1948 merumuskan batas bawah rata-rata bit per simbol yang disebut entropi:
dengan adalah peluang kemunculan simbol ke-. Untuk "MATEMATIKA", peluangnya , , dan , sehingga
Kode Huffman kita memakai rata-rata bit/huruf, hanya sedikit di atas batas . Selisih kecil ini muncul karena panjang kode Huffman harus bilangan bulat, padahal "panjang ideal" sering berupa pecahan. Kalau kamu ingin mengulang cara menghitung logaritma basis 2, baca materi Eksponen dan Logaritma.
Huffman terbukti optimal di antara metode yang mengodekan simbol satu per satu. Bila dibutuhkan rasio kompresi lebih baik, metode lain seperti arithmetic coding bisa dipakai karena tidak terikat panjang kode bulat.
Kode Python Algoritma Huffman
Program berikut memakai modul heapq bawaan Python sebagai antrean prioritas. Fungsi heappop selalu mengambil elemen terkecil, persis yang dibutuhkan langkah 2.
import heapq
from collections import Counter

def buat_kode_huffman(teks):
    frekuensi = Counter(teks)
    # Tiap entri heap: (frekuensi, nomor_urut, {huruf: kode})
    heap = [(f, i, {h: ""}) for i, (h, f) in enumerate(frekuensi.items())]
    heapq.heapify(heap)
    nomor = len(heap)
    while len(heap) > 1:
        f1, _, kiri = heapq.heappop(heap)   # frekuensi terkecil
        f2, _, kanan = heapq.heappop(heap)  # terkecil kedua
        gabung = {h: "0" + k for h, k in kiri.items()}
        gabung.update({h: "1" + k for h, k in kanan.items()})
        heapq.heappush(heap, (f1 + f2, nomor, gabung))
        nomor += 1
    return frekuensi, heap[0][2]

teks = "MATEMATIKA"
frekuensi, kode = buat_kode_huffman(teks)
for huruf, k in sorted(kode.items(), key=lambda x: (len(x[1]), x[0])):
    print(huruf, frekuensi[huruf], k)

hasil = "".join(kode[h] for h in teks)
print(hasil, len(hasil), "bit; ASCII:", 8 * len(teks), "bit")
Output:
A 3 10
T 2 00
E 1 010
I 1 011
K 1 110
M 2 111
1111000010111100001111010 25 bit; ASCII: 80 bit
Kolom nomor_urut dipakai sebagai pemecah seri: saat dua simpul punya frekuensi sama, Python membandingkan nomor ini sehingga tidak perlu membandingkan kamus. Coba ganti teks dengan namamu atau satu paragraf panjang, lalu bandingkan jumlah bitnya. Kalau kamu baru mulai belajar Python, mulai dulu dari Belajar Python dari Nol, dan untuk memahami arti baca Notasi Big O dan Kompleksitas Waktu.
Di Mana Huffman Dipakai Sekarang?
Huffman jarang bekerja sendirian. Biasanya ia menjadi tahap terakhir setelah tahap lain menyiapkan data.
| Teknologi | Peran kode Huffman/prefiks |
|---|---|
| DEFLATE (dipakai ZIP) | LZ77 mengganti potongan teks yang berulang dengan rujukan, lalu hasilnya dikodekan dengan kode Huffman |
| JPEG dan MP3 | Setelah tahap pemodelan dan kuantisasi, data dikodekan dengan kode prefiks |
| Faks, modem, jaringan, TV definisi tinggi | Contoh penerapan yang disebut UC Santa Cruz dalam berita wafatnya Huffman |
Spesifikasi DEFLATE (RFC 1951, 1996) menyebutkan bahwa formatnya memadukan algoritma LZ77 dan pengodean Huffman, dengan satu pohon kode untuk literal dan panjang, serta pohon terpisah untuk jarak. Jadi saat kamu mengompres folder tugas menjadi ZIP, ada dua trik yang bekerja: buang pengulangan dulu, lalu peras sisanya dengan Huffman.
Perlu dicatat, JPEG dan MP3 sendiri termasuk kompresi lossy karena tahap kuantisasinya membuang sebagian detail. Bagian Huffman-nya tetap lossless; yang membuang informasi adalah tahap sebelumnya.
Batasan yang Perlu Kamu Tahu
- Pohon harus ikut disimpan. Penerima perlu tahu kode setiap huruf. Untuk teks sangat pendek seperti "MATEMATIKA", ukuran tabel kode bisa lebih besar daripada penghematannya. Huffman baru terasa untung pada data yang panjang.
- Tidak bisa lebih kecil dari entropi. Data yang sudah acak atau sudah terkompresi (misalnya file JPG atau ZIP lain) hampir tidak menyusut lagi.
- Kode tidak tunggal. Kalau ada frekuensi yang sama, pilihan kiri-kanan bisa berbeda dan kodenya ikut berbeda, tetapi total bitnya tetap sama-sama minimum.
Ide memanfaatkan matematika agar data tetap utuh juga muncul di QR code, yang justru menambah bit cadangan supaya tahan rusak. Bandingkan di artikel Matematika di Balik QRIS.
Ringkasan
- Kompresi lossless seperti ZIP mengecilkan file tanpa menghilangkan informasi apa pun.
- Algoritma Huffman memberi kode biner pendek untuk simbol yang sering muncul dan kode panjang untuk yang jarang, dalam bentuk kode prefiks agar tidak ambigu.
- Pohon Huffman dibangun dari bawah: gabungkan dua simpul berfrekuensi terkecil berulang kali sampai tersisa satu akar.
- Kata "MATEMATIKA" menyusut dari 80 bit (8 bit per huruf) menjadi 25 bit, dekat dengan batas entropi sekitar 24,5 bit.
- David A. Huffman menemukan metode ini dari tugas makalah kuliah di MIT pada 1951 dan menerbitkannya pada 1952.
- Format DEFLATE yang dipakai ZIP memadukan LZ77 dengan pengodean Huffman.
Sumber belajar
- Huffman coding - Wikipedia
- RFC 1951: DEFLATE Compressed Data Format Specification version 1.3
- UC Santa Cruz: Eminent UCSC computer scientist David Huffman dies at age 74
- heapq — Heap queue algorithm (dokumentasi Python)
Penjelasan dan contoh disusun ulang untuk materi ini; sumber dapat dibuka untuk belajar lebih lanjut.
 Profil & karya lainnya